Kimi 发了个 K2.8,尴尬在哪?
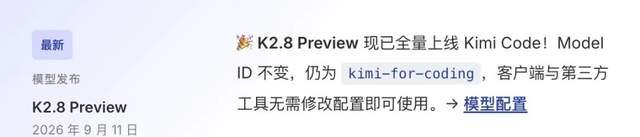
9 月 11 日下午,Kimi 把 K2.8 Preview 全量推给了所有 Kimi Code 用户。
没有发布会,没有预热,连模型 ID 都没换,还叫 kimi-for-coding。你在客户端里用,或者拿第三方工具接,配置一行都不用改,那边已经换成了新模型。
但这次更新真正改的东西,其实不在模型,在会员权益表。
先说一句,下面这些信息来自 Kimi Code 官方文档、IT之家和量子位的报道,还有一部分是社区里的实测反馈。预览版的东西变数大,等你看到这篇文章的时候,情况可能又变了。
版本号为什么是倒着发的
K3 是 7 月发的旗舰,2.8 万亿参数,1040 亿激活,1M 上下文,原生视觉,用的是 KDA 混合线性注意力那一套。发布的时候挺轰动,Arena.ai 的前端代码竞技场拿了 1679 分登顶,超过 Claude Fable 5 和 GPT-5.6 Sol。
然后一个多月后来了个 K2.8,数字比 K3 小。很多人第一反应是 Kimi 在倒着发版本。
B 站评论区有个比喻我觉得挺准,显卡厂在 20 系之后掏出个 1660,数字变小,实际是补一条更便宜的产品线。
官方给 K2.8 的定位是「综合性能接近 K3,思考效率更高」,另外加了一句,说它更适合代码补全和常规开发任务。
注意「接近」这两个字后面什么都没跟。这次预览更新,官方一个跑分都没公布。
真正的大动作是权益下放
模型怎么样先放一边,这次最实在的变化在权限上。
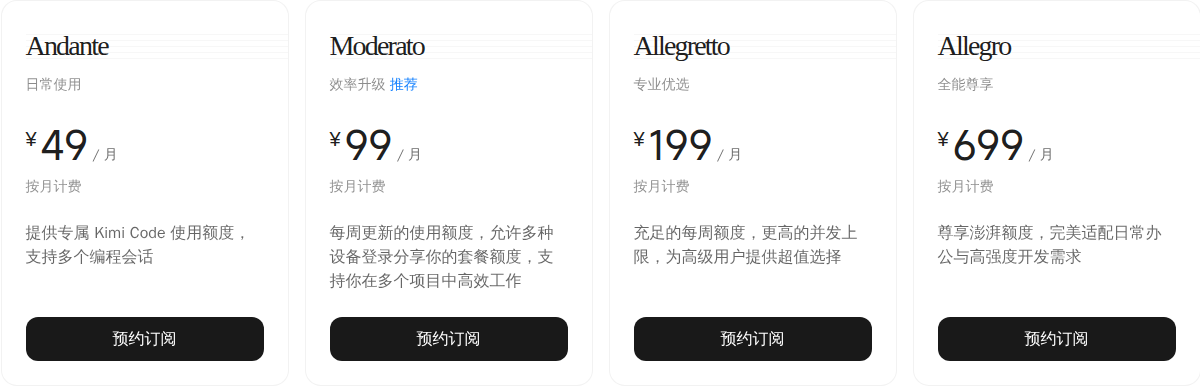
以前上下文长度是 Kimi 分档卖的卖点。K3 得 99 元的 Moderato 档以上才能调用,想用 1M 上下文还得上到 199 元的 Allegretto。再往下只有 256K。
现在 Kimi Code 官方文档写的是,K2.8 Preview 的 1M 上下文,全部会员档位开放。最便宜的 49 元月档也能用上百万级上下文。
1M token 是什么概念,按业内粗算大概能装 60 万到 80 万汉字,一个中型项目的代码加文档可以一次整个塞进去。
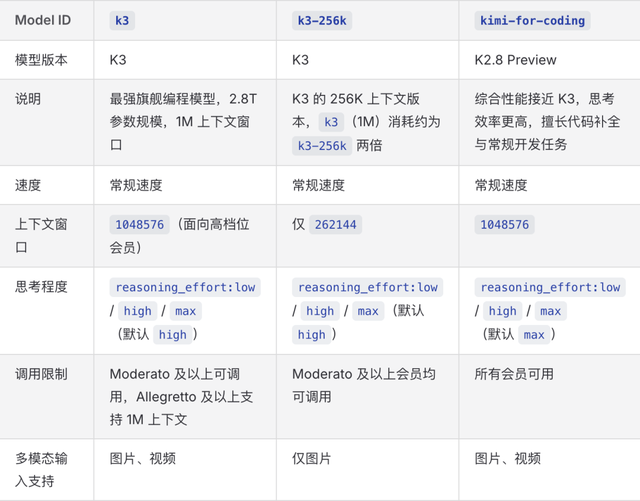
四个模型 ID 的规格摆在一起是这样。
有个细节容易被忽略。官方文档里写着,K3 系列和 K2.8 Preview 关闭 thinking 之后,请求都由 K2.8 Preview 的无思考版来处理。也就是说 K3 关掉思考,跑的其实是 K2.8。
另外,K2.8 Preview 的默认思考强度是 max 档,和 K3 的默认 high 不一样。第三方工具传进来的 effort 会做一层映射,填 ultra、max、xhigh 都会落到 max,填 high、medium 落到 high,填 low、minimum、light 落到 low,填 none 就是关掉思考。
一个口径上的差异
顺带说个我注意到的事。Kimi 主产品那边,帮助中心的会员权益表里,「K3 超长对话容量(支持百万 Tokens)」这一行目前只有 699 元的 Allegro 档打勾。而 Kimi Code 这边,K3 的 1M 是 199 元档起,K2.8 Preview 干脆全档位给。
同一个会员体系,两个产品的门槛不一样。这次下放的是 Kimi Code 这一侧。
实测口碑有点分裂
官方没放跑分,目前只有第三方实测。
B 站上 UP 主「无机酸」跑了一轮,结论大致是速度确实比 K3 快不少,但一次性生成的表现一般,纯写代码偏弱。他评论区有人拿 K2.8 写文档,说感觉挺好。知乎和 B 站上也有直接开骂的,说看不懂这个时候发 K2.8 的意义在哪。
我自己的感觉是,别把它当成 K3 打折版。K2.8 是在老 K2 底座上加强出来的,跟 K3 不是同一条技术路线,把它当成「够用的快模型」更贴切。
额度这件事得单独提醒
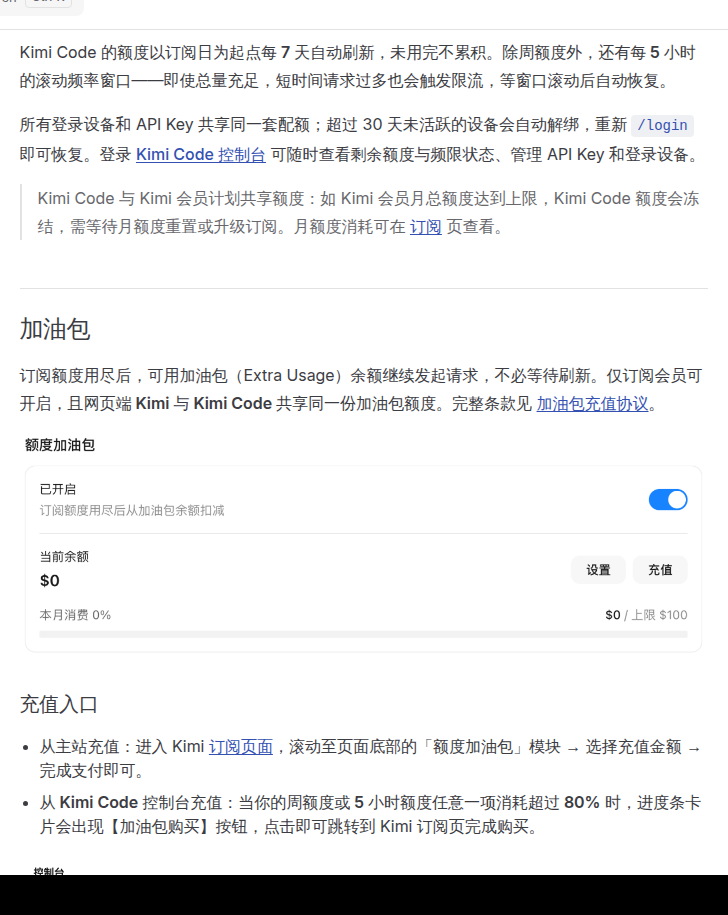
Kimi Code 的额度是三层限制,官方文档写得很清楚,我一开始也理解错了。
第一层是每 7 天刷新的周额度,以订阅日为起点刷新,用不完不累积。第二层是每 5 小时的滚动频率窗口,就算总量还富余,短时间请求太密也会被限流,得等窗口滚过去才恢复。第三层在会员那边,Kimi Code 和 Kimi 会员共享同一个额度池,会员的月总额度打满,Kimi Code 的额度会一起冻结。
有人在微博上晒过一笔账,让 K2.8 画一张「鹈鹕骑自行车」,一张图吃掉了 49 元月卡 5 小时额度的 48%。原因不复杂,默认思考强度开在最高的 max 档,想得多自然烧得快。
官方还给了两个计费示例,一次简单请求大约 0.03 元,规划一周成都到川西自驾行程那种多步任务大约 1.6 元。日常补全这类轻活几乎不心疼,重活才真花钱。
额度用尽还有一层兜底,官方叫加油包。开启后订阅额度打满会自动从加油包余额扣,任务不中断也不报错。周额度或 5 小时额度任意一项用到 80%,控制台会出现购买入口。单次最低充 25 元,余额上限 1 万元,余额不过期还能叠加。单位价格跟开放平台 API 差不多,所以用量大的话,升级订阅通常比充加油包划算。
官方文档也提示了,切换模型会让已经建立的上下文缓存失效,那部分上下文要重新预填充,刚切过去的时候消耗会偏高,建议切模型就新开一个会话。
如果你已经是会员,记住两个动作就够了,新开对话,额度紧张就把思考强度降一档。CLI 里敲 /usage 能直接查用量。
为什么偏偏这个时候发
这就得说到月之暗面正在跑的商业化节奏了。
据公开报道,它的 ARR 今年 3 月大约 1 亿美元,4 月到 2 亿,6 月超过 3 亿,8 月突破了 10 亿。公司内部希望年底冲到 20 亿。
估值曲线更陡。2025 年底 C 轮投后 43 亿美元,今年 5 月涨到 200 亿,7 月 F 轮后 350 亿,7 月底启动 Pre-IPO 轮,投前估值 500 亿美元。八个月涨了近八倍。本月初还有个消息,说它已经以保密形式向港交所递交了 A1 上市申请文件。
按 500 亿美元估值和当时公开的 3 亿美元 ARR 算,市销率大概 167 倍。做个参照,Anthropic 大约 20 倍,OpenAI 大约 40 倍,智谱万亿市值时大约 94 倍。
从 10 亿要冲到 20 亿,只靠一个高成本旗舰是撑不住的。
K3 贵、慢、吃资源,定价每百万 token 输入 3 美元输出 15 美元,虽然只有对手的三分之一,但算力吃紧是真的。K3 在技术博客里自己也提过,它对历史 thinking 内容比较敏感,Agent 框架没完整传回之前的思考记录时质量会不稳定,而且在模糊任务里容易自作主张,做出超出用户预期的决定。
所以它需要一个单位成本更低、能大规模铺开的主力模型。K2.8 就是来干这个的。
放到 9 月的大盘子里看
这件事单独看是一次普通的产品更新,放到 9 月这一堆动作里看,就有点意思了。我捋下来,这个月最明显的特征有三个,一个个对一下。
一,Flash 和轻量模型在密集迭代
9 月 2 日,Google 发了 Gemini 3.8 Flash,还带了个只给防守方开放的 Flash Cyber
8 月 26 日,智谱上线并开源 GLM-5.3-Flash,320B 总参数只激活 18B,原生多模态加 1M 上下文,是 GLM-5 系列第一个原生多模态的
9 月 8 日,DeepSeek 在官方群里放 V4.1 Flash 内测,新模型结构,原生多模态支持
9 月 11 日,Kimi K2.8 Preview 全量上线
一个月里四家都在动,而且发的都不是旗舰,都是能铺量的那一档。
原因不难想。旗舰模型负责刷榜、立牌子、拉估值,但真正跑量、真正撑收入的是便宜好用的那一档。K3 每天生成约 3000 亿 token 听着不少,可要支撑翻倍的 ARR,光靠它不够。
二,推理成本下降成了竞争焦点
这一块 9 月打得最凶。
9 月 1 日,Anthropic 发 Claude Fable 5.1,把缓存读取价从每百万 token 1 美元砍到 0.25 美元,降了 75%。有分析说这能带来 25% 到 45% 的整体成本节省。缓存读取这个价本身也是各家比拼的重点,现在已经压到标准输入价的一成左右。
Mistral 走的是极致性价比这条路。Mistral Large 3 定价每百万 token 输入 0.5 美元输出 1.5 美元,对比 GPT-5 的 1.25 和 10,输入便宜六成,输出便宜八成五,定位是「高性价比加可私有部署」。
国内这边,DeepSeek 9 月 10 日调了 Flash 系列价格,阿里腾讯也都在往下压。有个统计说国内大模型的词元价格已经降到国外的十分之一。另一个数字挺惊人,截至今年 6 月,国内日均词元调用量突破了 500 万亿。
这里有个反直觉的地方值得说。模型便宜了,不代表你的账单就降了。模型越快越便宜,你就越愿意把更重的任务丢给它,用得越狠,总花费反而可能上去。这也是为什么各家现在都盯着缓存命中率,同样结构的一段上下文,缓存命中价和未命中价能差出十倍以上。
三,Agent 和 Coding 成了差异化主战场
这个方向 9 月各家都在加码。
Anthropic 发 Fable 5.1 的时候,官方说法就是专门为支持长时智能体工作负载设计的。Google 的 Flash Cyber 只给防守方开放,也是冲着 Agent 场景的安全边界去的。
Kimi 这边砸得更直接。K3 靠编程能力立住了身位,Arena.ai 前端竞技场 1679 分登顶,编程基准上超过 Claude Opus 4.8 和 GPT-5.5,定价只有对手的三分之一,还开源了权重,是全球首个开源的 3 万亿级别模型。
Kimi Code 这条产品线补得也很密。8 月 5 日到 9 月 4 日,一个月里发了 9 个版本,加了子 Agent 模型池、Tower 多 Agent 协作、WaitFor 工具让 Agent 在当前轮次内等后台任务、Kimi Computer Use 支持 Windows,还有插件市场。这些补的全是 Agent 跑长任务时要用的东西。
K2.8 的落点也很清楚。代码补全和常规开发,是编程场景里调用量最大的那部分,也是最不需要旗舰模型的地方。
尴尬的地方,现在买不到
说了这么多好话,得说个硬的。
7 月 19 日,K3 发布同一周,月之暗面宣布因为算力紧张,暂停 C 端新用户付费订阅,算力优先留给已订阅的老用户。
我去翻官方定价页,四个档位的按钮清一色写着「预约订阅」。
小红书上有位重度用户晒过遭遇,免费额度用完后弹出「去升级」,点进去发现升级要先预约,等了两周也没排上号,最后一个对话都发不出去。这条帖子下面近百个点赞,大多是同病相怜的。
微博上有人 9 月 11 日上午晒「终于预约成功,开通 Kimi 会员,尝鲜」,说明预约通道在慢慢放人,但什么时候恢复全量购买,官方没有说法。
所以现在的局面挺吊诡。先进场的老用户,拿着 Kimi 历史上性价比最高的一张权益表。想进场的新用户,在门外排队。
几个没想明白的地方
第一,「综合性能接近 K3」到底接近多少。官方一个跑分都不放,只说接近。K3 发布的时候可是把基准、案例、技术博客全都摆出来的。这次这么安静,要么是还没准备好,要么是数据不太好看。
第二,权益下放和算力紧张放在一起看,有点矛盾。一边把 699 档的权益塞进 49 档,一边新用户买不到。如果算力真的紧张,把便宜档位的额度放宽,只会让紧张加剧。所以我更倾向于认为,这是在安抚已经付费的老用户,顺带为恢复开放之后做铺垫。拉新的诚意有几分,得看什么时候开门。
第三,K3 关掉 thinking 就路由到 K2.8,这个安排会让 K3 的定位慢慢收窄。以前 K3 的卖点是长程编程和深度推理,如果日常任务都被 K2.8 接走了,K3 就只剩最难的那部分活。对月之暗面自己是好事,单位调用成本降下来了,但买了 K3 权限的用户体感上会有落差。
第四,档位性价比。699 元的 Allegro 是 199 元 Allegretto 的 3.5 倍价格,额度只多大约 2.5 倍,越往高走单价越贵。如果你不是整天跑 Agent、几万行代码库那种强度,为了「1M 上下文」四个字直接冲最高档,不划算。
写在最后
作为一个断断续续用 Kimi 的人,这波操作我看得挺矛盾。
好的地方很实在。权益层面,这确实是 Kimi 历史上最划算的时候,49 元就能拿到百万级上下文,据我看到的范围,这是国内大厂里第一次把百万级上下文放进最低付费档。K2.8 的速度也确实上来了,日常写代码、改 bug、写文档这些活,够用。
别扭的地方也在明面上。门关着,官方一个跑分没放,预览版还挂着 Preview 的帽子,随时可能再变。而且我挺在意 K3 关思考就被接管这个设计,你付的是 K3 档的钱,日常跑的却可能是 K2.8。官方会说给的额度是 K3 等级的,但体感上终究有差别。
最后留三个观察点。预约订阅什么时候恢复全量开放,这个没明朗之前新用户一分钱不用花。K2.8 什么时候摘掉 Preview 的帽子、会不会补跑分。以及更高档位会不会跟进下放 K3 的百万上下文。
预约我先挂上了,剩下的等门开。
参考来源
Kimi Code 官方文档《最新动态》《模型配置》
Kimi 官方帮助中心《会员收费与套餐介绍》《会员订阅服务权益介绍》
IT之家《月之暗面 Kimi K2.8 Preview 模型全量上线 Kimi Code,综合性能接近 K3》
量子位《Kimi 突发 K2.8:性能逼近 K3,百万上下文全员开放》
什么值得买《Kimi 在 K3 之后发了 K2.8:699 元档才有的权益,49 元档也能用了,但现在买不到》
彭博社(月之暗面 ARR 与港股 IPO 相关报道)
什么值得买《今日 AI 圈值得关注的动态 2026 年 9 月 3 日》(Anthropic 缓存降价)
Local AI Zone《September 2026 AI Model Updates》(9 月模型发布与价格变动汇总)
Mistral 官方 API 定价页、Artificial Analysis 模型对比
Kimi 发了个 K2.8,把百万上下文打到了 49 元档,但你现在买不到了
本文采用 CC BY-NC-SA 4.0 许可协议,转载请注明出处。
评论交流
欢迎留下你的想法